


El “síndrome de Diógenes" de las empresas: ¿Qué hacer para no sucumbir a la acumulación excesiva de datos?
Lo hemos oído repetido mil veces: vivimos en la era de la información. Prácticamente todos los aspectos de nuestras vidas cuentan con la presencia de algún elemento digital e implican la transmisión o el guardado de datos, y, sin duda alguna, el aspecto laboral es uno de los que más destacan en este aspecto. También se nos ha dicho que para las empresas los datos son el nuevo oro, pero ¿Cuántos datos son demasiados datos? Y ¿Cómo afecta la acumulación excesiva de información a empresas y organizaciones? Y, sobre todo ¿Qué podemos hacer para poner freno y dar solución a esta saturación?
Para conocer las respuestas a estas preguntas, nos pusimos en contacto con el experto de VIU, Raúl Reyero Díez, coordinador del Máster Oficial en Big Data y Ciencia de Datos y profesor del Máster Oficial en Inteligencia Artificial de VIU.
P: En el entorno corporativo se habla cada vez más de la acumulación masiva de datos inútiles (Dark Data o datos oscuros). ¿Cómo definirías este "síndrome de Diógenes digital" empresarial? ¿Qué porcentaje estimado de los datos que almacena una empresa media realmente no sirve para nada y solo ocupa espacio?
R: El "síndrome de Diógenes digital" no es únicamente un problema de espacio. En realidad, es un problema de criterio. Guardamos datos por la misma razón por la que muchas personas siguen conservando cajas en el trastero: "No sé muy bien qué hay dentro, pero seguro que algún día puede hacer falta".
Lo curioso es que ese "algún día" casi nunca llega. Empiezan a aparecer registros antiguos, versiones repetidas, copias de seguridad de otras copias de seguridad y carpetas con nombres como definitivo, definitivo_2 o definitivo ahora sí. Si alguien dice que nunca ha hecho eso, probablemente no esté diciendo toda la verdad.
Conviene hacer una distinción importante. Los Dark Data no son necesariamente datos inútiles. Son datos que la empresa tiene almacenados, pero que no utiliza o cuyo valor desconoce. Algunos podrían resultar muy útiles si estuvieran bien clasificados. Otros sí son redundantes, obsoletos o triviales, los conocidos como datos ROT, y ahí es donde normalmente está el mayor margen de mejora.
Reconozco que tampoco soy inmune. Los que trabajamos con datos solemos pensar que algún archivo antiguo puede volver a ser útil y, si miro el trastero de casa, tampoco puedo presumir demasiado. De hecho, todavía conservo algún cargador de un teléfono que dejé de usar hace más de diez años "por si acaso". La diferencia es que, cuando ese mismo comportamiento se traslada a una empresa, deja de ser una pequeña manía y empieza a convertirse en un problema de costes, riesgos de seguridad y organización.
Sobre cuánto representa todo eso, no existe una cifra universal. Se suele citar un estudio de Veritas que estimaba que alrededor del 85 % de la información almacenada era oscura o pertenecía a la categoría ROT. Pero es un estudio con unos años a sus espaldas y elaborado por un proveedor tecnológico, así que yo sería prudente antes de extrapolar ese porcentaje a cualquier empresa.
Lo importante, más que el número, es la idea de fondo. Muchas organizaciones llevan años almacenando información sin saber realmente qué tienen, quién la utiliza o si sigue teniendo alguna utilidad.
P: Acumular gigabytes o terabytes de datos obsoletos (viejos logs, copias de seguridad de hace una década, borradores de proyectos) no es gratis. ¿Qué impacto económico y de rendimiento tiene para las empresas mantener servidores saturados de información inservible?
R: Hay una cosa que siempre me llama la atención cuando hablamos de este tema. Hoy discutimos sobre si merece la pena borrar determinados datos, cuando hace treinta años la conversación era exactamente la contraria: el problema era dónde conseguir más espacio.
Lo viví bastante de cerca. Cuando empecé como becario en Oracle allá por los años noventa trabajábamos con sistemas Unix y las copias de seguridad se hacían en cintas. El almacenamiento era caro y nadie guardaba información porque sí. Cada megabyte contaba. Y casi sin darnos cuenta hemos acabado en el extremo contrario: almacenar es tan barato que muchas veces dejamos de preguntarnos si realmente merece la pena conservar algo.
Y ahí aparece el coste que casi nunca vemos. Un archivo no ocupa solo un hueco en un disco. También entra en las copias de seguridad, se replica, se protege frente a ataques, se migra cuando cambia la infraestructura... Es un poco como alquilar un trastero porque ya no cabe nada en casa y descubrir después que también hay que pagar el seguro, mantenerlo y seguir trasladando las cajas cada vez que uno se muda.
Después está el tiempo. Me parece un coste incluso más importante. Buscar un documento entre miles de archivos mal clasificados recuerda bastante a buscar una aguja en un pajar, solo que aquí hay diecisiete agujas iguales y ninguna tiene el nombre correcto.
Y, por supuesto, está la seguridad. Cuantos más datos conserva una organización, más información tiene que proteger. En ocasiones el problema no es perder un dato importante, sino descubrir que llevábamos diez años guardando información personal que ya no tenía ninguna razón para seguir allí.
P: Existe una creencia popular de que "la nube" es etérea y limpia. ¿Podrías explicarnos cómo impacta este "Diógenes digital" al medio ambiente? ¿Hasta qué punto limpiar y optimizar los servidores mediante ciencia de datos reduce la huella de CO2 de las corporaciones?
R: Creo que el nombre "la nube" nos ha jugado una mala pasada. Suena ligero, casi etéreo, y eso hace que olvidemos que detrás hay algo muy físico: edificios llenos de servidores, redes, sistemas de refrigeración... Todo eso consume electricidad, agua y recursos materiales.
Es curioso porque usamos estos servicios todos los días y apenas pensamos en ello. Guardamos una fotografía, enviamos un correo o hacemos una copia de seguridad y da la sensación de que todo desaparece en algún lugar abstracto. En realidad, no desaparece; simplemente deja de estar delante de nuestros ojos.
Por eso limpiar los datos también tiene una dimensión ambiental. Si conseguimos reducir información innecesaria, disminuyen las copias de seguridad, las transferencias y parte del almacenamiento que la empresa necesita mantener activo. En algunos casos incluso puede retrasarse la ampliación de la infraestructura.
Pero aquí hay un matiz importante. Borrar un 20 % de los archivos no significa reducir automáticamente un 20 % las emisiones. Eso dependerá de si esa limpieza permite utilizar menos recursos físicos.
A veces tendemos a pensar que la sostenibilidad depende únicamente de grandes decisiones tecnológicas. Mi impresión es que también depende de muchas pequeñas decisiones cotidianas. Seguramente borrar diez copias olvidadas de una presentación no cambie el mundo, pero cuando ese mismo criterio se aplica de forma sistemática en una organización durante años, la diferencia puede notarse.
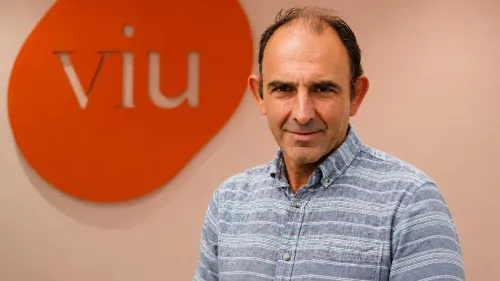
Raúl Reyero en la sede central de VIU en Valencia
P: Para solucionar esto no basta con darle al botón de suprimir de forma manual. ¿Cómo ayuda la ciencia de datos a automatizar este proceso? ¿En qué consiste exactamente programar un "borrado inteligente" y cómo decide un algoritmo qué información es prescindible y cuál es crítica?
R: Aquí suele haber un pequeño malentendido. Cuando se habla de "borrado inteligente", mucha gente imagina una inteligencia artificial entrando en un servidor y decidiendo por su cuenta qué archivos desaparecen. En realidad, funciona justo al revés.
La decisión importante se toma mucho antes. Es la propia empresa la que define qué considera un dato relevante y cuál ha dejado de tener utilidad. Para eso se analizan cuestiones bastante prácticas: si el archivo sigue vinculado a un proyecto activo, si contiene datos personales o si existe alguna obligación legal de conservarlo. Una vez fijadas esas reglas, los algoritmos pueden aplicarlas de forma consistente sobre millones de documentos.
Un ejemplo sencillo. Un documento que está duplicado varias veces, que nadie ha abierto desde hace ocho o diez años y que pertenece a un proyecto cerrado probablemente acabará en la lista de candidatos para archivarse o eliminarse. En cambio, un contrato o un registro de auditoría seguirán otro camino, aunque tengan la misma antigüedad.
Lo importante es que el algoritmo no inventa las reglas. Las aplica de forma consistente y a una escala que ninguna persona podría asumir revisando carpetas una por una.
P: ¿Cómo se estructuran matemáticamente estas directrices de limpieza? ¿Qué variables de negocio y técnicas analiza un algoritmo antes de decidir eliminar permanentemente un bloque de datos?
R: Al final, los matemáticos tenemos cierta tendencia a convertir problemas complejos en algo que se pueda medir. Esto no es muy distinto.
En lugar de preguntarnos simplemente si un dato es útil o no, intentamos valorar distintas características. ¿Hace cuánto que no se utiliza? ¿Tiene relación con un proceso que sigue activo? ¿Existe otra copia? ¿Está sujeto a alguna obligación legal? Cada una de esas preguntas aporta información.
Podemos imaginar que cada archivo recibe una especie de puntuación de conservación. No deja de ser una forma de ordenar prioridades. Cuanto mayor sea el valor que aporta a la organización o mayor sea la obligación de conservarlo, menos sentido tendrá eliminarlo.
Lo interesante es que no hace falta recurrir siempre a modelos muy sofisticados. A veces funcionan mejor unas reglas sencillas y bien definidas, que una inteligencia artificial difícil de interpretar. Cuando una decisión puede terminar borrando información de forma irreversible, es preferible que cualquiera pueda entender por qué el sistema ha llegado a esa conclusión.
P: ¿Cómo se mitiga el riesgo de que la IA o el modelo matemático elimine por error un dato que en el futuro podría ser valioso? ¿Dónde reside el equilibrio entre la limpieza radical y la conservación estratégica del conocimiento empresarial?
R: Creo que aquí ocurre algo parecido a lo que pasa con muchas aplicaciones de la inteligencia artificial. Tendemos a imaginar sistemas casi autónomos que toman decisiones complejas por sí solos, cuando la realidad suele ser bastante menos glamurosa y, en mi opinión, bastante más útil.
En un proceso de limpieza de datos, el verdadero valor de la IA no está en que "decida qué borrar", sino en ayudar a localizar patrones, detectar duplicados, identificar información que lleva años sin utilizarse o señalar casos que merecen una revisión. Después entran en juego los criterios que la propia organización ha definido y, cuando el impacto puede ser importante, el criterio de las personas.
Es una idea que a veces sorprende. Cuanto más crítico es un proceso, menos interés suele haber en que el algoritmo improvise. Lo que se busca es exactamente lo contrario: que sea predecible, que explique por qué ha llegado a una determinada conclusión y que todos los casos similares reciban el mismo tratamiento.
Por eso, cuando hablamos de borrado inteligente, la imagen de una inteligencia artificial tomando decisiones por su cuenta resulta bastante engañosa. En la práctica, lo que encontramos es una combinación de reglas bien definidas, modelos que ayudan a clasificar la información y supervisión humana allí donde realmente aporta valor.
P. ¿Es común que las empresas no limpien sus bases de datos simplemente porque "no ven" lo que tienen acumulado? ¿Cómo ayuda una buena arquitectura de visualización a que los directivos tomen conciencia del desorden de su infraestructura digital?
R: Sí, y además ocurre con más frecuencia de lo que parece. Hay empresas que saben que tienen un problema con sus datos, pero si les preguntas dónde está exactamente, la respuesta suele ser un silencio bastante incómodo.
Me he encontrado situaciones en las que aparece un servidor funcionando desde hace años y nadie sabe muy bien para qué sigue ahí. Preguntas a un departamento, te envían a otro y, al final, alguien recuerda que aquello lo montó una persona que ya ni siquiera trabaja en la empresa. Contado así parece una anécdota, pero ocurre sorprendentemente a menudo.
Por eso la visualización resulta tan útil. No porque resuelva el problema por sí sola, sino porque lo hace visible. De repente puedes ver cuánto almacenamiento existe, cómo ha ido creciendo o qué parte lleva años sin utilizarse. Es mucho más fácil tomar decisiones cuando el problema deja de ser una sensación y empieza a aparecer delante de ti con datos concretos.
En el fondo ocurre igual que en cualquier organización. Lo que no se mide, o simplemente no se ve, acaba quedando siempre para más adelante.
P: El Big Data y la ciencia de datos aplicada parecen a veces exclusivos de las grandes tecnológicas. Sin embargo, has dirigido trabajos sobre la aplicación de estas tecnologías en PYMEs. ¿Cómo afecta este problema de saturación a las pequeñas y medianas empresas y por qué deberían aplicar ellas también el borrado inteligente?,
R: A veces se piensa que este tipo de problemas solo afectan a las grandes tecnológicas porque son las que manejan volúmenes enormes de información. Mi experiencia es justo la contraria. Las PYMEs suelen notarlo antes porque tienen mucho menos margen para desperdiciar tiempo y recursos.
Cuando trabajas con pequeñas empresas aparecen situaciones muy reconocibles: varias versiones del mismo documento, discos externos que nadie se atreve a tocar, carpetas compartidas que han ido creciendo durante años o cuentas en la nube que siguen vinculadas a personas que hace tiempo dejaron la empresa.
No hace falta desplegar una gran plataforma de inteligencia artificial para empezar a poner orden. Muchas veces basta con saber qué información existe, quién la utiliza realmente y qué puede archivarse sin ningún impacto para la actividad diaria. De hecho, es un perfil que cada vez demandan más las empresas: profesionales capaces de organizar, interpretar y gobernar sus datos antes incluso de aplicar modelos de inteligencia artificial. Es algo que comprobamos en cada edición en los másteres de Big Data y Ciencia de Datos y de Inteligencia Artificial de VIU. Algunos de nuestros estudiantes llegan precisamente con el reto de poner orden en los datos de sus organizaciones.
Al final, una PYME no necesita almacenar más información que una gran empresa. Lo que necesita es saber con qué información puede tomar mejores decisiones.
P: El borrado inteligente de datos también toca de lleno regulaciones como el RGPD. ¿Puede la automatización del borrado ser una herramienta clave para garantizar que las empresas cumplan éticamente con el "derecho al olvido" de los usuarios y clientes?
R. Sí, y probablemente sea una de las aplicaciones menos visibles de la inteligencia artificial, aunque también una de las más útiles.
Cuando hablamos del derecho al olvido solemos imaginar que basta con borrar un registro de una base de datos. En la práctica el problema es bastante más complicado. Ese mismo dato puede seguir apareciendo en una hoja de cálculo, en una copia de seguridad, en un entorno de pruebas o en un archivo que alguien exportó hace años.
La automatización ayuda precisamente a localizar toda esa información y a aplicar las mismas reglas de conservación en todos los sistemas. Eso reduce errores y evita depender de que alguien recuerde revisar manualmente cada repositorio.
Naturalmente, siempre habrá información que deba conservarse por motivos legales. Ahí la tecnología no sustituye la decisión humana. Lo que hace es facilitar que esas decisiones se apliquen de forma coherente y que, unos años después, todavía podamos explicar por qué un dato se conservó... o por qué se eliminó.
P: Si tuvieras que lanzar un mensaje o recomendación urgente a los responsables de tecnología (CTOs) y directivos sobre cómo empezar a aplicar un "plan de desintoxicación digital" en sus servidores utilizando la ciencia de datos, ¿Cuál sería?
R: Si tuviera que dar un único consejo sería este: no empezaría comprando más almacenamiento ni buscando una herramienta de inteligencia artificial. Empezaría intentando entender qué información tiene realmente la empresa.
Parece una recomendación demasiado sencilla, pero muchas organizaciones nunca han hecho ese ejercicio. Saben cuánto espacio ocupan sus datos, pero no cuáles siguen siendo útiles, cuáles están duplicados o cuáles llevan años sin que nadie los consulte.
Yo comenzaría por un repositorio concreto. Haría un inventario, hablaría con las personas que trabajan con esa información todos los días y probaría el proceso en un entorno pequeño. Cuando una empresa comprueba que puede recuperar espacio sin generar problemas, es mucho más fácil que el proyecto continúe creciendo.
Da la impresión de que hablamos mucho de incorporar nuevas tecnologías y bastante menos de entender bien las que ya tenemos, y muchas veces el problema empieza a resolverse precisamente ahí.

-

Máster Universitario en Big Data y Ciencia de Datos
Ciencia y TecnologíaFórmate como Data Scientist con un Título Oficial enfocado en la empleabilidad y las tecnologías más demandadas (Python, R, Spark).
-
Máster Universitario en Inteligencia Artificial
Ciencia y TecnologíaCon el máster en IA online obtendrás una visión integradora y el dominio de las técnicas más demandadas por la industria, como Machine Learning y Optimización Computacional, de manera totalmente práctica.
-

Grado en Ciencia de Datos e Inteligencia Artificial
Ciencia y TecnologíaFórmate con las herramientas y tendencias más actuales para convertirte en uno de los profesionales especializados más demandados por el mercado.
-

Máster en Inteligencia Artificial para la Transformación e Innovación de Negocio
EmpresaFórmate para impulsar y liderar proyectos empresariales de IA, convirtiéndote en un profesional clave para la transformación digital.
-

Programa de Doctorado en Ciencia de Datos y Big Data
Ciencia y Tecnología


